Kalibrierung der Bewertung: Warum eine gemeinsame Bewertungsmatrix dennoch zu uneinheitlichen Bewertungen führt11 Minute gelesen
Fünf Bewerter bewerten dieselben fünf Ideen anhand derselben Bewertungsvorlage und derselben Kriterien. Bei einem Kriterium liegt die Bandbreite der Bewertungen zwischen 2 und 8.
Die Scorecard funktioniert einwandfrei, aber darunter befinden sich vier Dinge:
- Eine einheitliche Definition dessen, was die einzelnen Bewertungsstufen bedeuten eigentlich bedeutet
- Beispiele, an denen sich die Gutachter orientieren können – nicht nur zur Diskussion
- Eine strukturierte Sitzung, die verhindert, dass frühe Meinungen die Stimmung im Raum beeinflussen
- Eine Möglichkeit, mit den sich ändernden Trends Schritt zu halten, wenn Zyklen vergehen und neue Gutachter hinzukommen
Dafür ist keine neue Bewertungsmatrix erforderlich. Es braucht vielmehr Prüfer, die dieselben Kriterien lesen, die auf dieselbe Weise, jedes Mal.
Genau diese Lücke ist es, die einen “strukturierten” Prozess ohnehin subjektiv erscheinen lässt. Die Kalibrierung ist die Maßnahme, die diese Lücke schließt, doch die meisten Teams lassen sie komplett aus.
So funktioniert diese Vorgehensweise in der Praxis – vom Erstellen von Referenzbeispielen bis hin zur einheitlichen Ausrichtung eines Panels, auch wenn sich die Prüfer ändern.
Eine Scorecard ist keine Garantie
Eine Bewertungsrubrik gibt den Gutachtern vor, was sie berücksichtigen. Es sagt ihnen nicht, wie sie wiegen was sie sehen.
Zwei Personen können dasselbe Bewertungskriterium lesen und es in gegensätzlicher Weise anwenden, wobei beide davon überzeugt sind, dass sie die Anweisungen befolgt haben. Das liegt daran, dass die meisten Bewertungsrubriken abstrakt formuliert sind.
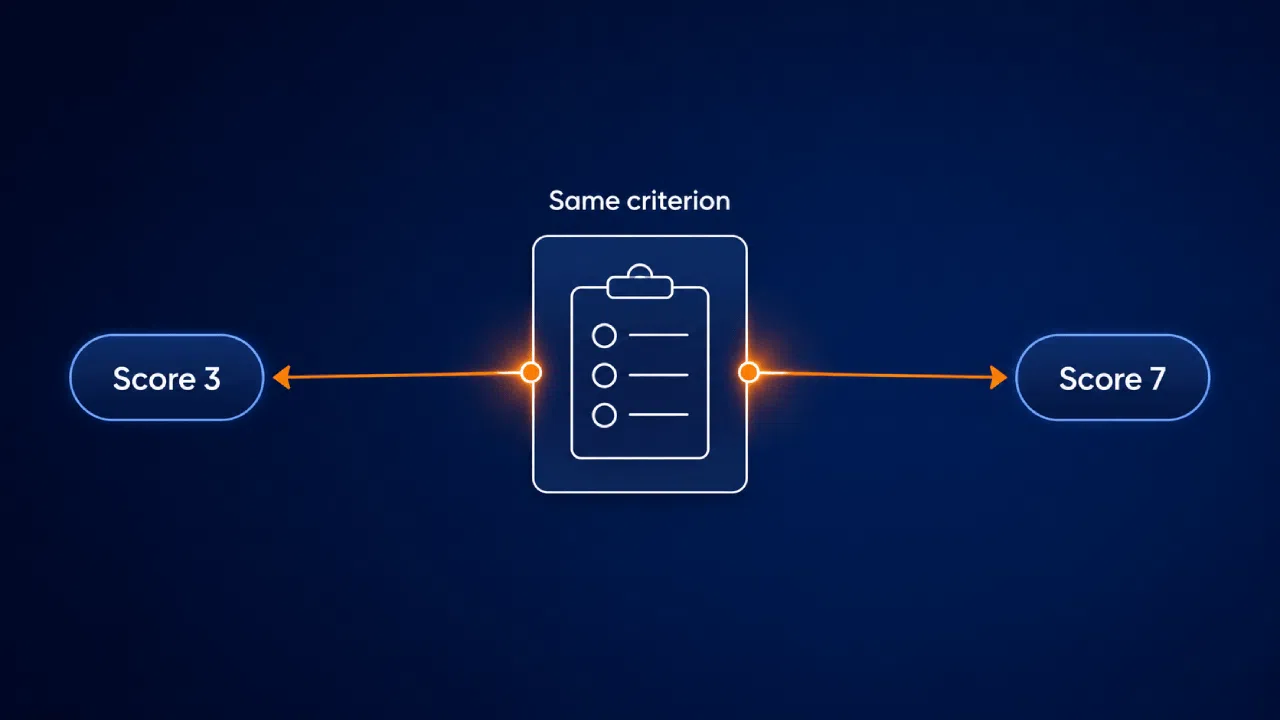
Wie es in einem Kalibrierungsprotokoll heißt: Selbst wenn sich die Bewerter auf eine Bewertungsrubrik einigen, wenden sie diese oft unterschiedlich an, da der Wortlaut interpretationsfähig ist.
Die Machbarkeit wird in der Regel weniger einheitlich bewertet als Kriterien wie Originalität oder Klarheit. Dabei werden die Gutachter gebeten, die realen Rahmenbedingungen hinsichtlich Ressourcen und Umsetzung zu beurteilen, die sich aus der Idee selbst nicht vollständig ableiten lassen.
Beim Thema Machbarkeit gehen die Meinungen der Gutachter am stärksten auseinander, und die Ursachen dafür sind immer dieselben:
- Vage Kriterienbeschreibungen, die zu viel Interpretationsspielraum lassen
- Es gibt keine gemeinsamen Referenzbeispiele, an denen die Gutachter einen Vergleich vornehmen könnten
- Verankerungsbias aufgrund dessen, wer zufällig als Erster punktet
Jedes dieser Elemente vergrößert die Kluft zwischen “Wir haben einen strukturierten Prozess” und “Wir haben eine einheitliche Bewertung”. Das ist nicht dasselbe, und das eine führt nicht automatisch zum anderen.
Was Kalibrierung eigentlich bedeutet
Zwei kritische Gutachter können dieselbe Idee betrachten und zu unterschiedlichen Schlussfolgerungen gelangen. Das ist oft angemessen.
Was durch die Kalibrierung abgeglichen wird, ist Bedeutung: Worauf sich die einzelnen Kriterien konkret beziehen und was die einzelnen Bewertungsstufen darstellen sollen.
Stell dir das einfach als ein Wortschatz Sport.
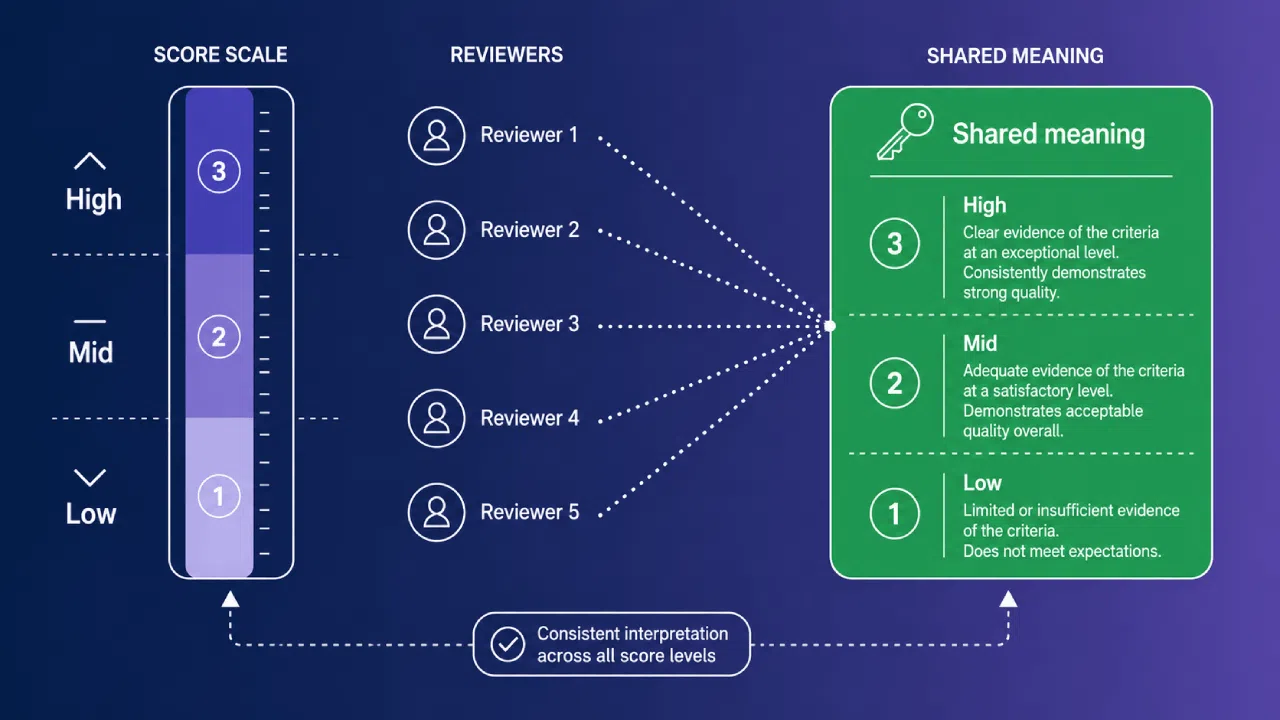
Wie ein Praktiker es formuliert, sorgt die Kalibrierung dafür, dass sich die Bewerter darüber einig sind, was die Kriterien bedeuten, “damit Meinungsverschiedenheiten zu Signal anstatt Lärm.”
Ein gut abgestimmtes Gremium führt zu Entscheidungen, hinter denen die Menschen stehen können, ein gemeinsames Urteil mit einer klaren Dokumentation darüber, wie es zustande gekommen ist.
Erstellen Sie Ihren eigenen Anker-Beispielsatz
Beispiele für Anker sind die mit Abstand nicht ausreichend genutzt Werkzeug zur Kalibrierung. Jede davon ist eine Idee, die mit ihrer “richtigen” Punktzahl und einer Erklärung versehen ist, warum sie diese Punktzahl erhält.
Anker leiten Rezensenten von Schlussfolgerung zu Beobachtung. Anstatt zu fragen: “Fühlt sich das wie eine 7 an?”, vergleicht ein Rezensent die Idee mit einem vereinbarten Bezugspunkt.
| Punktestand | Beispielbeschreibung | Warum diese Bewertung? |
|---|---|---|
| 2 (Geringe Machbarkeit) | Die Idee erfordert eine behördliche Genehmigung, die das Unternehmen noch nie erhalten hat, und es gibt weder einen internen Träger noch einen Präzedenzfall auf dem Markt. | Mehrere erhebliche Hindernisse, für die keine Lösung gefunden wurde. Die Bewertung spiegelt den Aufwand wider, der jeden realistischen kurzfristigen Ertrag übersteigt. |
| 5 (Mäßige Machbarkeit) | Die Idee passt zum bestehenden Tech-Stack, erfordert jedoch einen neuen Lieferantenvertrag und teamübergreifende Kapazitäten, die noch nicht bestätigt sind. | Es gibt einen gangbaren Weg, doch wesentliche Abhängigkeiten bleiben ungelöst. „Mid-scale“ deutet auf echte Unsicherheit hin und ist kein Platzhalter. |
| 8 (Hohe Machbarkeit) | Die Idee nutzt bereits vorhandene Tools, hat einen namentlich genannten Verantwortlichen und eine vergleichbare Version, die im Rahmen einer früheren Kampagne veröffentlicht wurde. | Klarer Weg, bewährtes Vorbeispiel, minimale neue Abhängigkeiten. Reserviert für Ideen, mit denen das Team realistisch gesehen noch in diesem Quartal beginnen könnte. |
Wie viele Ankerpunkte benötigen Sie? Streben Sie zwei bis drei pro Punktestufe an, wobei der Schwerpunkt auf den Mitte des Skalenbereichs, in dem es den Gutachtern am schwersten fällt, Unterschiede zu erkennen.
Die Extreme sind einfacher, da ein klarer Sieger und ein klarer Außenseiter selten zu Streitigkeiten führen.
Die Machbarkeit verdient zusätzlich Investition angesichts ihrer geringen Relevanz im Innovationskontext. Schaffen Sie dort mehr Anknüpfungspunkte und gestalten Sie jeden Deskriptor verhaltensbezogen.
Anker können Sie an drei Stellen beziehen:
- Frühere Ideen, die Sie bereits bewertet haben und die vor der Wiederverwendung anonymisiert wurden
- Synthetische Konstruktionen, die zur Veranschaulichung einer bestimmten Stufe verfasst wurden
- Angepasste Beispiele aus ähnlichen Kampagnen
“Hat einen namentlich genannten Verantwortlichen und eine genehmigte Haushaltslinie” ist besser als “realistisch umsetzbar”, denn das eine ist beobachtbar und das andere ist ein Gefühl.
Das Ziel ist ein kleines, prägnantes Set, das verdeutlicht, wie Ihr Team eigentlich meint.
Kalibrierung von Mehrkriterien-Scorecards
Die meisten echten Scorecards messen nicht nur eine einzige Sache. Sie bewerten eine Idee anhand mehrerer gewichteter Kriterien:
- Durchführbarkeit
- Markttauglichkeit
- Strategische Ausrichtung
- Und noch mehr
Jedes Kriterium kalibrieren für sich allein. Wenn man die Gutachter nur anhand der endgültigen Gesamtbewertung aufeinander abstimmt, bleibt verborgen, wo die Meinungsverschiedenheiten tatsächlich liegen.
Zwei Gutachter können aus gegensätzlichen Gründen zu derselben Gesamtbewertung gelangen: Der eine bewertet die Durchführbarkeit hoch, die Eignung jedoch niedrig, der andere umgekehrt. Die Gesamtbewertung Masken zerstreutes Urteilsvermögen.
Die Reihenfolge der Punkte ist wichtiger, als die Mannschaften annehmen.
Eine vielschichtige Rasch-Analyse ergab, dass der Halo-Effekt messbar zunimmt, wenn Gutachter verwandte Kriterien direkt nacheinander bewerten, wodurch ein starker Eindruck das nachfolgende Kriterium beeinflusst.
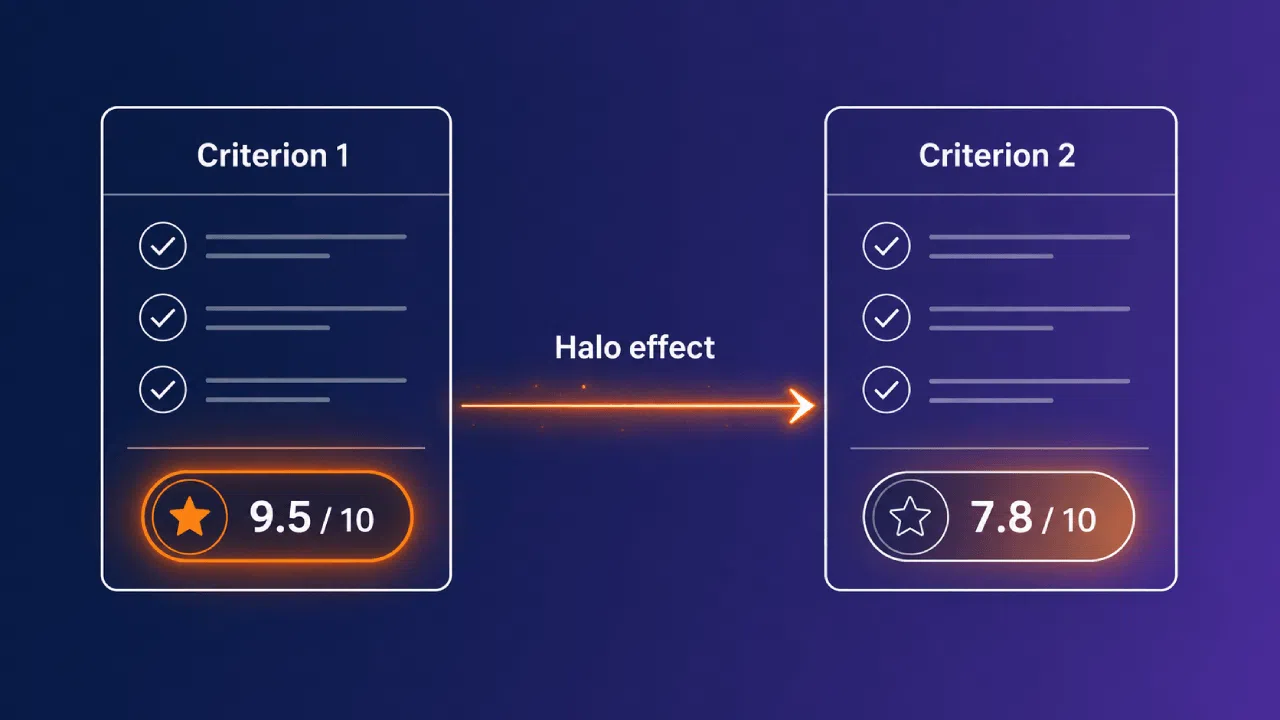
Eine Gewichtung kann ein Kriterium, das uneinheitlich bewertet wird, nicht retten. Eine stärkere Gewichtung eines ungenauen Kriteriums verstärkt dessen Einfluss, nicht dessen Genauigkeit.
Aus diesem Grund reicht ein allgemeines Ankerset nicht aus. Eine “7” für die Machbarkeit und eine “7” für die strategische Eignung beschreiben verschiedene Beweise, und eine Referenzmenge hebt diesen Unterschied auf.
Erstellen Sie für jede relevante Dimension einen kriterienspezifischen Ankersatz. Verwenden Sie dabei wieder dieselbe Struktur mit zwei bis drei Ankerpunkten pro Stufe, formulieren Sie die Beschreibungen jedoch so, dass sie genau das widerspiegeln, was das jeweilige Kriterium tatsächlich misst.
Der zusätzliche Aufwand fällt vor allem zu Beginn an und macht sich in jedem Zyklus bezahlt. Sobald jedes Kriterium über eigene Anker verfügt, hören die Prüfer auf, Argumente aus einer Dimension zu übernehmen, um eine andere zu begründen.
So führen Sie eine Kalibrierungssitzung durch
Die Vorbereitungsaufgabe lautet nicht verhandelbar.
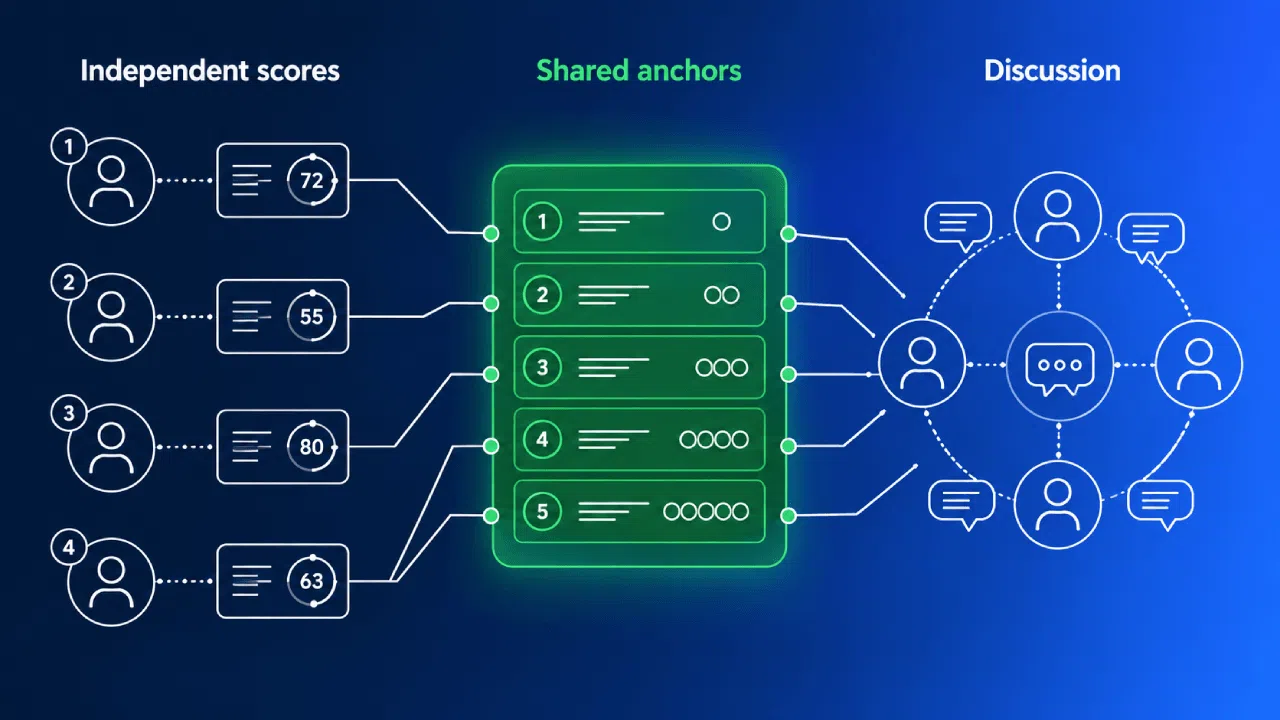
Die Gutachter bewerten die Referenzbeispiele vor der Sitzung unabhängig voneinander, idealerweise innerhalb eines Zeitraums von 48 Stunden; andernfalls wird die Sitzung zu einer Suche nach Belegen statt zu einer Kalibrierung.
Die Sitzung selbst folgt einer bewusst festgelegten Reihenfolge, damit die ersten Meinungen nicht unbemerkt alle anderen beeinflussen können:
- Der Moderator erläutert den Kontext: welches Kriterium, welche Ankerpunkte, was die Skala bedeutet.
- Die Gruppe sieht sich gemeinsam und schweigend die Bewertungskriterien und das Beispiel an.
- Die Prüfer stellen ausschließlich klärende Fragen, über die Bewertung wird noch nicht gesprochen.
- Jeder Gutachter vergibt eine eigenständige Bewertung und begründet diese schriftlich.
- Die Ergebnisse werden nacheinander bekannt gegeben, ohne dass eine Erklärung dazu gegeben wird, sodass die Streuung sichtbar ist, bevor jemand eine Zahl verteidigt.
- Der Moderator eröffnet die Diskussion über die Abweichungen, anschließend bespricht die Gruppe, was vereinheitlicht werden soll.
Halten Sie die Trainingseinheiten auf 45 bis 90 Minuten mit vier bis acht Teilnehmern begrenzt, je nach Trainingszyklus. Sind sie länger, übernimmt die Ermüdung die Entscheidung für Sie.
Die wichtigste Regel ist in Schritt fünf enthalten: Niemand nennt seine Punktzahl, bis alle hat eine. Dies gleicht den Verankerungseffekt aus, da die Punktzahlen die Menschen in der Reihenfolge beeinflussen, in der sie bekannt gegeben werden.
Dann gibt es noch den dominanten Gutachter. Wenn eine Person immer wieder abweichende Meinungen vertritt und heftig argumentiert, Der Moderator hält sich an den gemeinsamen Standard als Bezugspunkt für den Raum.
Gehen Sie während der Diskussion laut eine kurze Checkliste zum Thema Voreingenommenheit durch:
- Recency-Effekt
- Halo- und Horn-Effekte
- Zentralwert (alle Werte konzentrieren sich auf 5)
- Eine Vorliebe für Ideen, die den eigenen Ansichten des Rezensenten ähneln
Ein neutraler Moderator, der diese Punkte in Echtzeit anspricht, sorgt dafür, dass das Gespräch auf dem Boden der Tatsachen bleibt. Indem man ein Name Ein Muster ist es, das verhindert, dass es die Partitur still und leise prägt.
Häufige Fehler bei der Kalibrierung
Eine Kalibrierung kann in bester Absicht durchgeführt werden und dennoch nach hinten losgehen. Dabei treten immer wieder bestimmte Fehlermuster auf:
- Eine offene Diskussion als Lösung betrachten. Unstrukturierte Gruppendiskussionen führen innerhalb einer Gruppe zu größerer Übereinstimmung, verstärken jedoch die Meinungsunterschiede zwischen den Gruppen, sodass sich zwei separat kalibrierte Gruppen weiter voneinander entfernen statt sich anzunähern.
- Ausnahme für erfahrene Rezensenten. Erfahrung schützt niemanden vor Abweichungen; Auffrischungsschulungen erhöhten die Zuverlässigkeit sogar bei erfahrenen Bewertern.
- Die Rubrik umschreiben und es dabei belassen. Eine klarere Bewertungsrubrik allein sorgt nicht für Konsistenz, da die Erfahrung der Prüfer als entscheidender Faktor für zuverlässige Bewertungen eine größere Rolle spielt als das Format der Rubrik.
Der erste Fehler ist der größte nicht intuitiv. Eine Diskussion, die ein Gefühl der Einigkeit im Raum vermittelt, kann still diesen Raum so gestalten, dass dort ein lokaler Konsens entsteht, den kein anderes Gremium teilt.
Die Struktur ist es, die dies verhindert. Eine unabhängige Bewertung vor der Diskussion und ein gemeinsamer Bewertungsrahmen sorgen dafür, dass das Gespräch an eine Standard statt der lautesten Stimme.
Die „Veteranen-Ausnahme“ ist aus einem einfachen Grund verlockend. Erfahrene Scorer sind selbstbewusst, und dieses Selbstbewusstsein wirkt sich positiv auf die Treffsicherheit aus – selbst wenn beides insgeheim schon lange nichts mehr miteinander zu tun hat.
Die Neugestaltung der Rubrik hat denselben Reiz. Sie fühlt sich wie Fortschritt, weil er ein sichtbares Ergebnis hervorbringt, während die mühsamere Arbeit, Menschen aufeinander abzustimmen, unberücksichtigt bleibt.
Keiner dieser Fehler ist für sich genommen fatal. Sie werden erst dann kostspielig, wenn ein Team davon ausgeht, dass die Kalibrierung fertig und hört auf zu prüfen.
Die Lücke zwischen den Zyklen schließen
Die Kalibrierung ist kein einmaliger Vorgang, und die Wartungsarbeiten sind weniger aufwendig, als es zunächst klingt.
Die Interpretation der Prüfer verändert sich im Laufe der Zyklen, wenn neue Mitarbeiter hinzukommen und die Erinnerung an die letzte Sitzung verblasst. Zwei Schwellenwerte sollten im Auge behalten werden:
- Eine durchschnittliche Abweichung von 10 Punkten zwischen den Bewertern bedeutet, dass die Bewertungsrubrik aktualisiert werden muss.
- Eine Zuverlässigkeit von weniger als 75 Prozent Übereinstimmung nach vier Sitzungen bedeutet, dass die Anker eine umschreiben, keine weitere Diskussion.
Führen Sie monatliche Besprechungen durch und ein gemeinsames Entscheidungsprotokoll führen, in dem festgehalten wird, warum grenzwertige Ideen so bewertet wurden, wie sie bewertet wurden. Auf diese Weise bleibt die Begründung erhalten, anstatt immer wieder neu diskutiert zu werden.
Ein Teilnehmer, dessen Punktzahl deutlich über oder unter dem Gruppendurchschnitt liegt, liefert einen nützlichen Anhaltspunkt. Dieses Muster zeigt genau wo das nächste Kalibrierungsgespräch beginnen soll.
Einarbeitung neuer Gutachter
Wenn ein neuer Gutachter einem kalibrierten Gremium beitritt, ist kein vollständiger Neustart der Sitzung erforderlich. Das Gremium erfüllt bereits den Standard; es geht lediglich darum, eine Person auf den neuesten Stand zu bringen.
Beginnen Sie damit, die Teilnehmer anhand Ihres vorab bewerteten Referenzsatzes zu qualifizieren. Dies entspricht der formalen Qualifizierung von Bewertern, bei der vor der Live-Bewertung eine Mindestübereinstimmungsrate bei den Benchmark-Items erreicht werden muss.
Eine schrittweise Einführung verhindert, dass ein neuer Gutachter seine eigenen Daten importiert privat Maßstab:
- Beobachten Sie. Nehmen Sie an einer Live-Kalibrierung oder einer Bewertungssitzung ohne Bewertung teil, um zu erfahren, wie die Jury ihre Überlegungen laut ausspricht.
- Co-Score. Bewerten Sie dieselben Ideen gemeinsam mit einem erfahrenen Kollegen, vergleichen Sie anschließend die Bewertungen und besprechen Sie jede Diskrepanz.
- Solo-Partitur. Wechseln Sie zur unabhängigen Bewertung, sobald die Abweichungen bei der gemeinsamen Bewertung innerhalb des für das Gremium üblichen Bereichs liegen.
Es gibt kaum direkte Forschungsergebnisse zu genau diesem Szenario.
Die Einbindung in ein etabliertes, kalibriertes Panel wurde bislang noch nicht eigenständig untersucht. Lesen Sie diese Sequenz als Ton Extrapolation aus der gängigen Qualifikationspraxis, nicht aus feststehenden Tatsachen.
Zieh eine klare Grenze zwischen gemeinsamer Bewertung und Einzelarbeit. Wenn die Übereinstimmungsrate mit den Ankerwerten übereinstimmt oder nur eine geringe Abweichung vom erfahrenen Korrektor vorliegt, weißt du, dass der Korrektor bereit ist.
Behalten Sie den ersten Solo-Durchlauf im Rahmen einer oberflächlichen zweiten Durchsicht im Auge. Eine kurze Stichprobenprüfung bei grenzwertigen Ergebnissen deckt Abweichungen frühzeitig auf, bevor sie zur Gewohnheit werden.
Wo KI zum Einsatz kommt
KI funktioniert hier am besten als Gerüst das die Entscheidung des Prüfungsgremiums stützt.
Dadurch wird der implizite Standard sichtbar gemacht, es werden Stellen aufgezeigt, an denen zwei Partituren voneinander abweichen, und dem Gremium wird eine einheitliche Bezugsgrundlage geboten, auf die es reagieren kann.
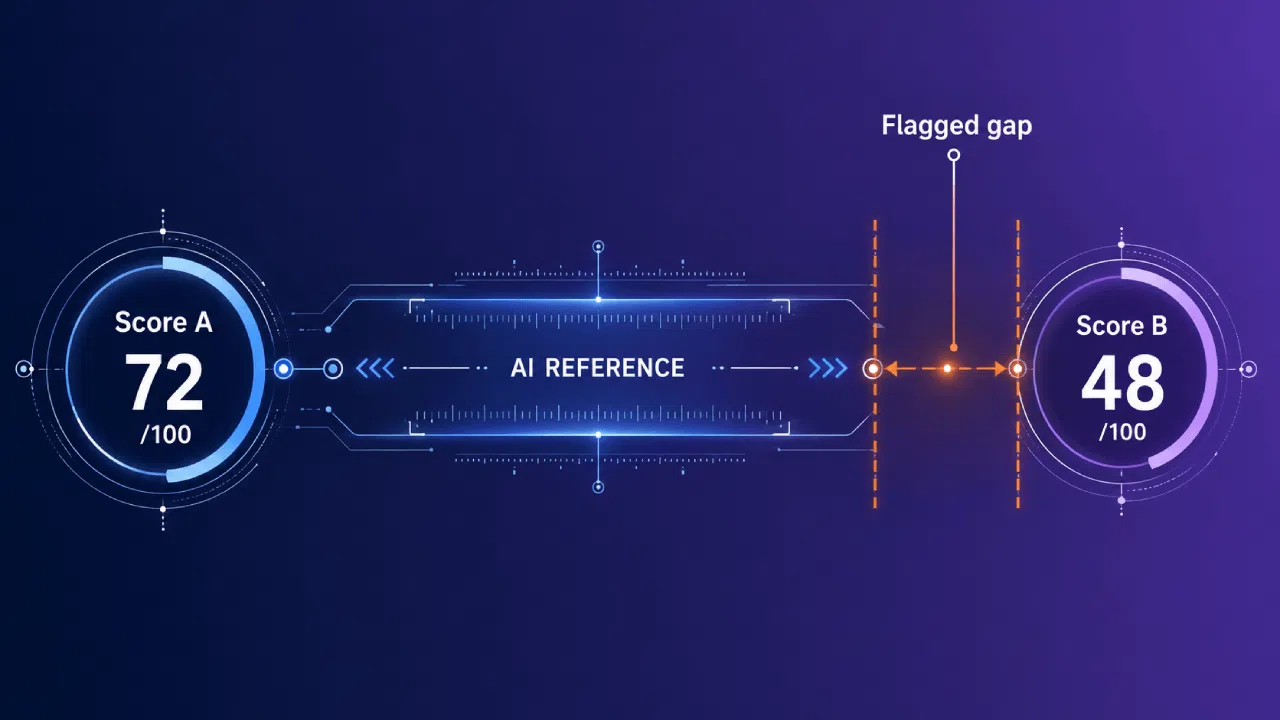
Die Beweislage spricht dafür, dass Zusammenarbeit über eines der beiden Extreme hinaus.
EIN von Fachkollegen begutachtete Studie Es zeigte sich, dass die gemeinsame Benotung durch Menschen und KI die Abweichung von den Experten-Benchmarks stärker reduzierte als jeder der beiden Ansätze für sich allein.
Hier kommt die Unterstützung durch strukturierte KI-Bewertung ins Spiel:
- Einheitliche Kriterien
- Konfigurierbare Skalen
- Automatische Markierungen bei Inkonsistenzen
Dadurch können sich die Gutachter auf die wirklich wichtigen Aspekte konzentrieren.
Das Ergebnis ist messbar: weniger umstrittene Bewertungen, schnellerer Konsens und Entscheidungen, die das Gremium mit Beweise anstelle von Instinkt.
Die Kalibrierung ist das System hinter der Scorecard
Eine Scorecard ist nur so gut wie das gemeinsame Verständnis dahinter. Die Zahlen siehe objektiv, aber sie haben genau die Bedeutung, die die Rezensenten ihnen zugeschrieben haben.
Durch die Kalibrierung wird dieses gemeinsame Verständnis zu etwas langlebig:
- Ein einheitlicher Begriffsbestand dafür, was die einzelnen Bewertungsstufen konkret bedeuten
- Eine Sitzungsstruktur, die verhindert, dass früh geäußerte Meinungen die Diskussion in eine bestimmte Richtung lenken
- Eine Möglichkeit, eine schleichende Veränderung zu erkennen, bevor sie still und leise die Bedeutung von “gut” neu definiert
- Ein schnellerer Weg zur Einarbeitung neuer Gutachter, ohne dabei Abstriche beim Standard zu machen
Unternehmen, die darin investieren, treffen Entscheidungen, die Moment mal. Sie überarbeiten ihre Arbeiten seltener, begründen ihre Bewertungen mit Belegen und schaffen durch eine klare Struktur Vertrauen bei den Prüfern.
Betrachte es als ein trainierbar Disziplin. Eine einzige Sitzung reicht nicht aus, um ein Team dauerhaft aufeinander abzustimmen, aber die Arbeit summiert sich über mehrere Zyklen hinweg.
Beginnen Sie mit den Beispielen, die als Anker dienen. Sie sind die Maßnahme mit der größten Wirkung, die Sie in diesem Quartal ergreifen können, und alles andere baut darauf auf.
Laden Sie unser Ebook herunter über Ideenbewertung und Steuerung, oder Buchen Sie eine Demo um zu sehen, wie Accept Mission automatisiertes Routing, Eskalationsworkflows und Prüfprotokolle handhabt.




 English
 Dutch
 Portuguese
 Spanish
 French
 German
 Arabic