Calibración de la puntuación: por qué una rúbrica compartida sigue dando lugar a valoraciones inconsistentes11 lectura mínima
Cinco evaluadores puntúan las mismas cinco ideas utilizando la misma tabla de puntuación y los mismos criterios. En uno de los criterios, la variación de las puntuaciones oscila entre 2 y 8.
La ficha de puntuación funciona bien, pero debajo hay cuatro cosas:
- Una definición común de lo que supone cada nivel de puntuación en realidad significa
- Ejemplos de referencia con los que los revisores puedan comparar, no solo debatir
- Una sesión estructurada que evita que las primeras opiniones influyan en el resto de los asistentes
- Una forma de ponerse al día a medida que pasan los ciclos y se incorporan nuevos revisores
Nada de esto requiere una nueva ficha de evaluación. Lo que se necesita son evaluadores que lean los mismos criterios que de la misma manera, siempre.
Esta es la brecha que hace que un proceso “estructurado” resulte, de todos modos, subjetivo. La calibración es la práctica que permite cerrarla, y la mayoría de los equipos la omiten por completo.
A continuación te explicamos cómo funciona realmente esa disciplina, desde la creación de ejemplos de referencia hasta cómo mantener la coherencia del panel a medida que van cambiando los revisores.
Una ficha de puntuación no es una garantía
Una rúbrica indica a los evaluadores qué deben tener en cuenta. No les dice cómo pesar lo que ven.
Dos personas pueden leer el mismo criterio y aplicarlo de forma opuesta, ambas convencidas de que han seguido las instrucciones. Esto ocurre porque la mayoría de las rúbricas están redactadas de forma abstracta.
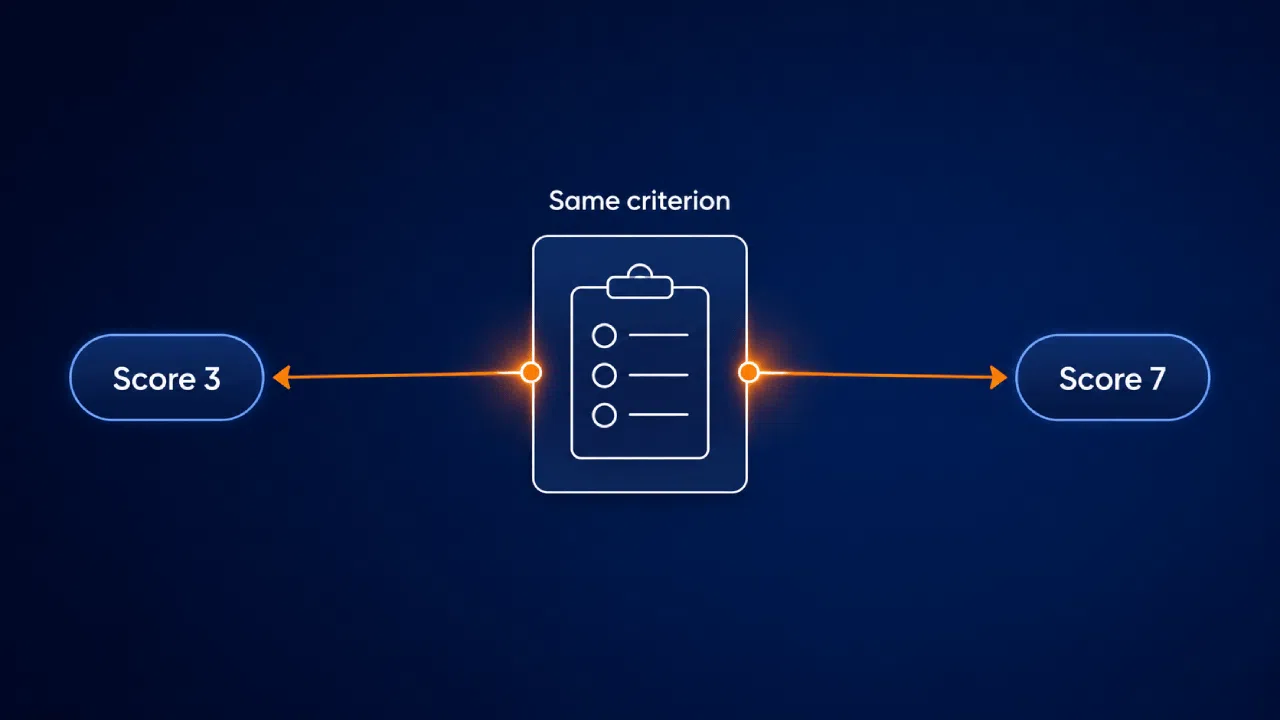
Tal y como señala un protocolo de calibración, incluso cuando los evaluadores están de acuerdo en una rúbrica, a menudo la aplican de forma diferente porque la redacción da lugar a interpretaciones.
La viabilidad suele mostrar un grado de consenso menor que criterios como la originalidad o la claridad. Exige a los evaluadores que valoren aspectos relacionados con los recursos y la ejecución que la idea en sí misma no revela por completo.
La viabilidad es el aspecto en el que los evaluadores discrepan más, y las causas fundamentales son siempre las mismas:
- Descripciones de criterios imprecisas que dejan demasiado margen para la interpretación
- No hay ejemplos de referencia comunes con los que los revisores puedan comparar
- El sesgo de anclaje derivado de quién sea que marque el primer gol
Cada uno de ellos aumenta la distancia entre “tenemos un proceso estructurado” y “tenemos una puntuación coherente”. No son lo mismo, y lo uno no implica lo otro.
Qué significa realmente la calibración
Dos críticos reflexivos pueden analizar la misma idea y llegar a conclusiones diferentes. Eso suele ser adecuado.
Lo que la calibración ajusta es significado: a qué se refiere realmente cada criterio y qué se supone que representa cada nivel de puntuación.
Piensa en ello como un vocabulario ejercicio.
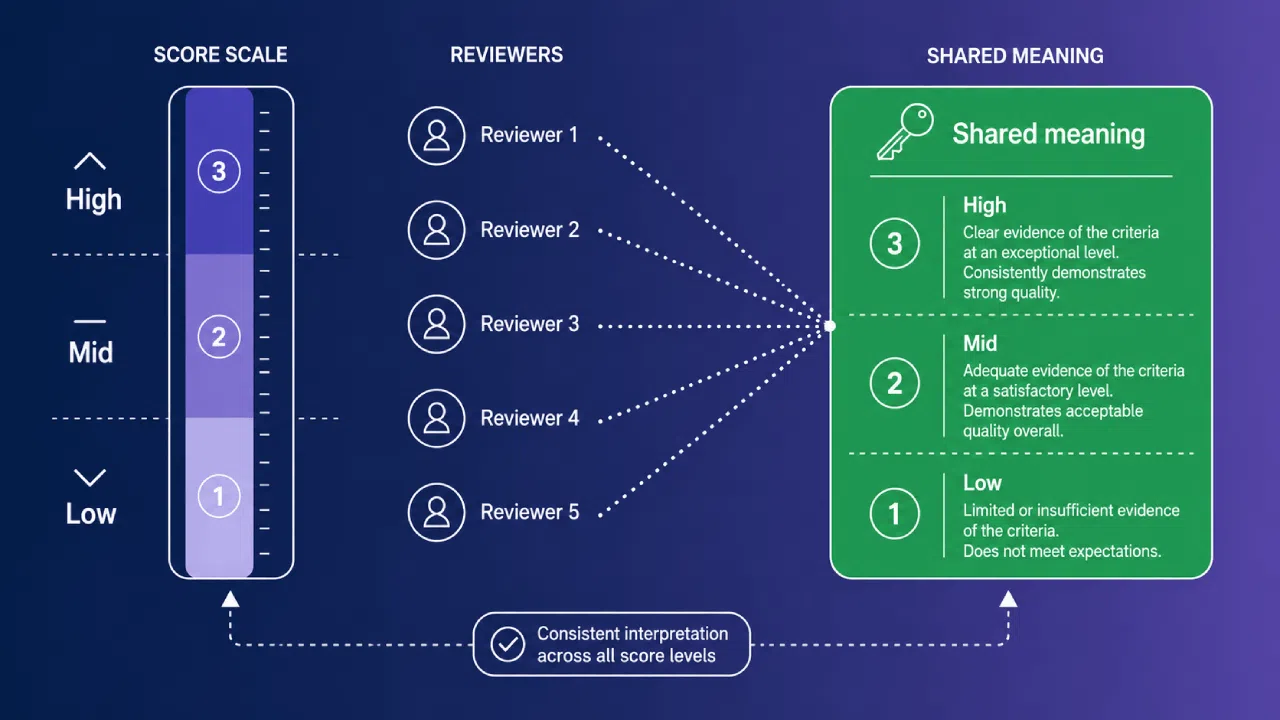
Tal y como lo explica un profesional, la calibración hace que los evaluadores se pongan de acuerdo sobre el significado de los criterios “para que las discrepancias se conviertan en señal en lugar de ruido.”
Un panel bien calibrado genera decisiones con las que la gente puede identificarse, una sentencia dictada de forma colegiada con un historial claro de cómo se llegó a ella.
Crea tu conjunto de ejemplos de referencia
Los ejemplos de «anchor» son, sin duda, los más infrautilizado herramienta de calibración. Cada una de ellas es una idea a la que se le ha asignado su puntuación “correcta” y una explicación de por qué obtiene esa puntuación.
Los «anchors» hacen que los revisores pasen de inferencia a observación. En lugar de preguntarse “¿esto me parece un 7?”, el crítico compara la idea con un punto de referencia acordado.
| Nivel de puntuación | Descripción del ejemplo | ¿Por qué esta puntuación? |
|---|---|---|
| 2 (Baja viabilidad) | La idea requiere una autorización reglamentaria que la empresa nunca ha obtenido, no cuenta con un responsable interno y no tiene precedentes en el mercado. | Existen múltiples obstáculos insuperables y no se ha identificado ninguna vía de solución. La puntuación refleja un esfuerzo que supera cualquier beneficio realista a corto plazo. |
| 5 (Viabilidad moderada) | La idea encaja con la pila tecnológica actual, pero requiere un nuevo contrato con el proveedor y una capacidad interdepartamental que aún no se ha confirmado. | Existe una vía viable, pero siguen sin resolverse algunas dependencias reales. «A media escala» indica una incertidumbre real, no es un término provisional. |
| 8 (Alta viabilidad) | La idea utiliza herramientas ya existentes, tiene un responsable designado y una versión similar que se lanzó en una campaña anterior. | Un camino claro, un precedente contrastado y un mínimo de nuevas dependencias. Reservado para ideas que el equipo pueda poner en marcha de forma realista este trimestre. |
¿Cuántos puntos de referencia necesitas? Intenta tener entre dos y tres por nivel de puntuación, dando mayor peso a los centro de la escala en la que a los evaluadores les cuesta más distinguir.
Los casos extremos son más sencillos, ya que un ganador claro y un candidato sin posibilidades rara vez dan lugar a discusiones.
La viabilidad merece extra inversión, dada su escasa relevancia en los contextos de innovación. Establecer más puntos de referencia en ese ámbito y hacer que cada descriptor conductual.
Puedes conseguir anclas en tres sitios:
- Ideas anteriores que ya has valorado, anonimizadas antes de su reutilización
- Ejercicios sintéticos elaborados para ilustrar un nivel concreto
- Ejemplos adaptados extraídos de campañas similares
“Tener un responsable designado y una partida presupuestaria aprobada” es mejor que “sea realista de llevar a cabo”, porque lo primero es observable y el otro es un sensación.
El objetivo es crear un conjunto breve y conciso que refleje cómo tu equipo en realidad piensa.
Calibración de cuadros de mando multicriterio
La mayoría de los indicadores de rendimiento reales no miden una sola cosa. Evalúan una idea en función de varios criterios ponderados:
- Factibilidad
- Ajuste del mercado
- Alineación estratégica
- Y más
Calibrar cada criterio por sí sola. Basarse únicamente en la puntuación final global para poner de acuerdo a los evaluadores oculta dónde se encuentra realmente el desacuerdo.
Dos evaluadores pueden llegar a la misma puntuación total por razones opuestas: uno le da una puntuación alta en viabilidad y baja en adecuación, y el otro, al revés. La puntuación compuesta máscaras juicio disperso.
El orden en el que se marcan los goles es más importante de lo que los equipos creen.
Un análisis de Rasch multifacético reveló que el efecto halo se hace apreciable cuando los evaluadores valoran criterios relacionados uno tras otro, lo que permite que una impresión muy marcada influya en el criterio siguiente.
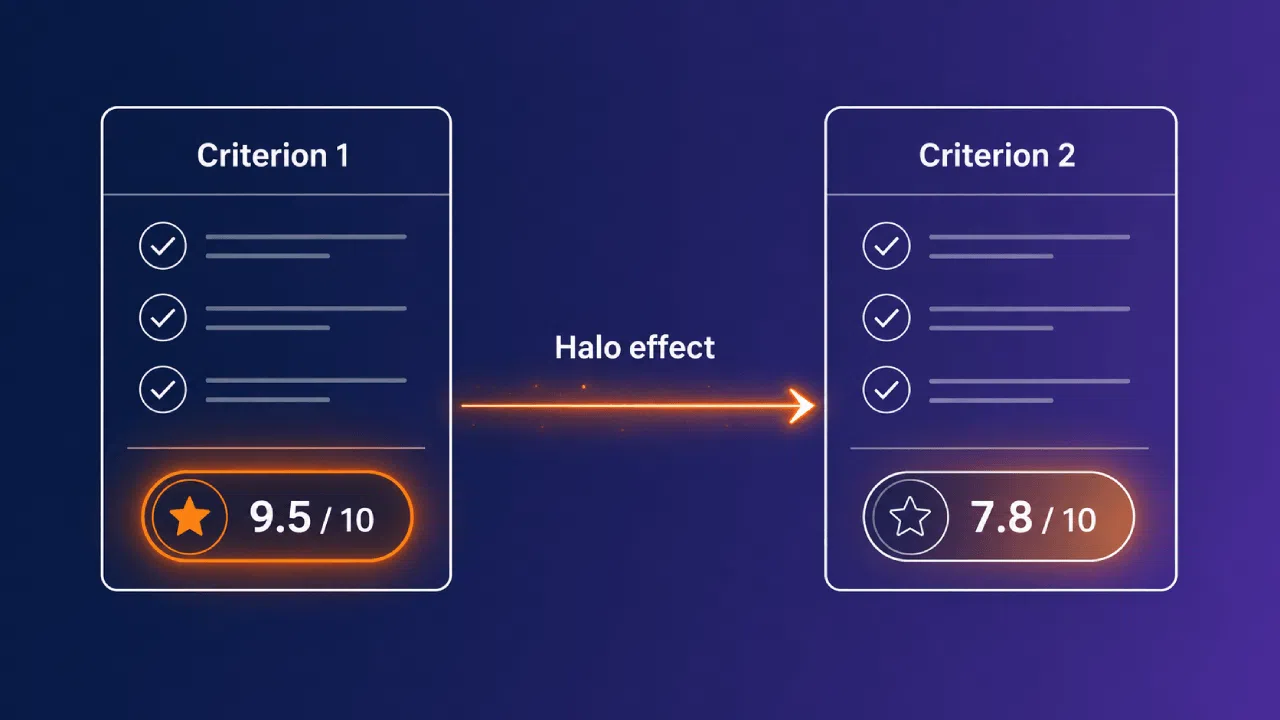
La ponderación no compensa un criterio cuya puntuación es inconsistente. Atribuir una mayor ponderación a un criterio con datos ruidosos amplifica su influencia, no su precisión.
Por eso, un conjunto genérico de criterios de referencia no es suficiente. Un “7” en viabilidad y un “7” en adecuación estratégica describen diferente las pruebas, y un conjunto de referencia elimina esa distinción.
Elabora un conjunto de descriptores específicos para cada criterio de cada dimensión relevante. Reutiliza la misma estructura de dos o tres descriptores por nivel, pero redacta los descriptores en función de lo que ese criterio concreto mida realmente.
El trabajo adicional se concentra al principio del proceso y se amortiza en cada ciclo. Una vez que cada criterio cuenta con sus propios puntos de referencia, los revisores dejan de recurrir a la lógica de una dimensión para justificar otra.
Cómo llevar a cabo una sesión de calibración
La tarea previa consiste en no negociable.
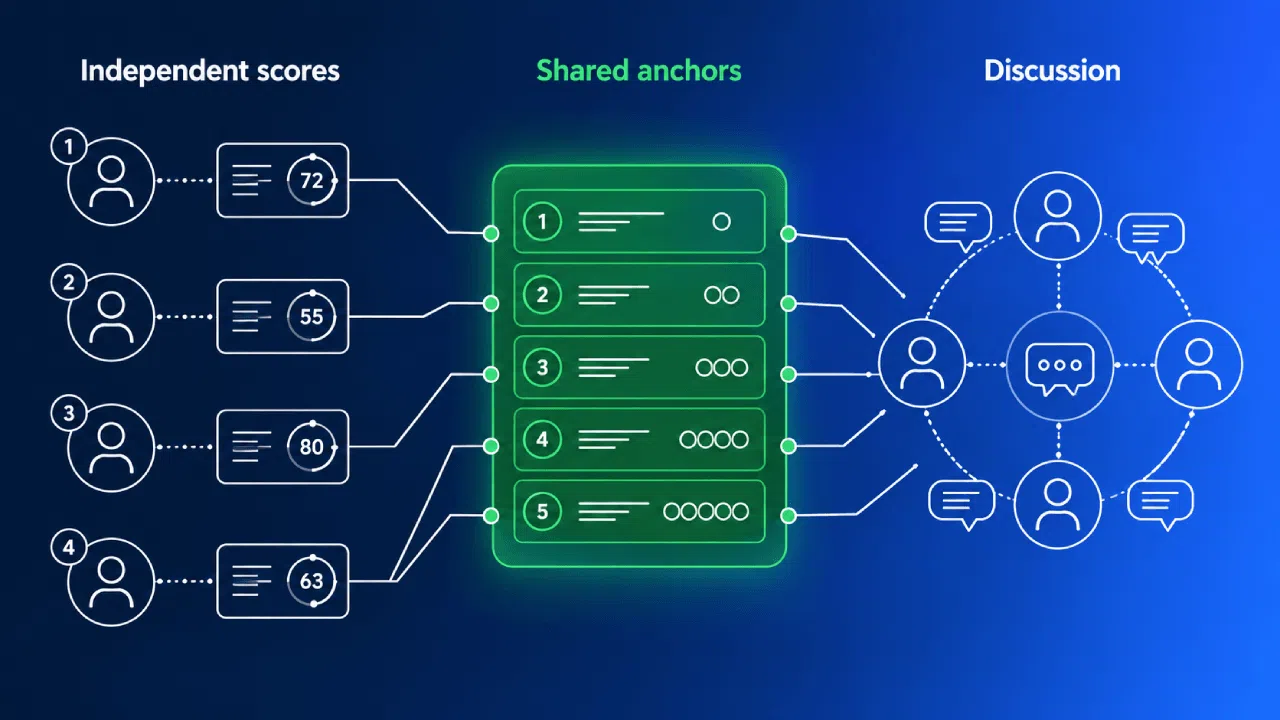
Los revisores puntúan los ejemplos de referencia de forma independiente antes de la sesión, a ser posible con un margen de 48 horas; de lo contrario, la reunión se convierte en una búsqueda de pruebas en lugar de en un proceso de calibración.
La sesión en sí sigue un orden deliberado para que las primeras opiniones no puedan influir discretamente en el resto de los participantes:
- El moderador establece el contexto: qué criterio, qué puntos de referencia y qué significa la escala.
- El grupo examina en silencio y de forma conjunta la rúbrica y la idea de ejemplo.
- Los evaluadores solo hacen preguntas para aclarar dudas; de momento no se habla de puntuaciones.
- Cada evaluador asigna una puntuación independiente y la justifica por escrito.
- Las puntuaciones se van revelando una a una, sin explicación alguna, de modo que la diferencia queda patente antes de que nadie defienda una cifra.
- El moderador abre el debate sobre las divergencias y, a continuación, el grupo analiza qué aspectos deben unificarse.
Las sesiones deben durar entre 45 y 90 minutos, con entre cuatro y ocho participantes, en función del ciclo. Si se alargan más, el cansancio empezará a influir en los resultados.
La regla fundamental se encuentra en el quinto paso: nadie dice su puntuación hasta que todo el mundo tiene uno. Esto controla el sesgo de anclaje, ya que las puntuaciones influyen en las personas según el orden en que se revelan.
Luego está el revisor dominante. Cuando una persona discrepa constantemente y discute con vehemencia, el moderador es quien establece la norma común como punto de referencia de la habitación.
Lee en voz alta una breve lista de comprobación sobre sesgos durante el debate:
- Efecto de recencia
- Efectos de halo y bocina
- Tendencia central (todos los valores se agrupan en torno al 5)
- Sesgo de afinidad hacia ideas que se asemejan a las del propio revisor
Un moderador imparcial que vaya señalando estos aspectos en tiempo real ayuda a que la conversación se mantenga con los pies en la tierra. Poner un nombre Es precisamente el hecho de ceñirse a un patrón lo que impide que este moldee discretamente la partitura.
Errores habituales en la calibración
La calibración puede llevarse a cabo con la mejor intención y, aun así, salir mal. Hay algunos patrones de fallo que se repiten con frecuencia:
- Considerar que el debate abierto es la solución. Las conversaciones grupales no estructuradas fomentan el consenso dentro de un panel, al tiempo que acentúan las divergencias entre paneles, por lo que dos paneles calibrados por separado se alejan aún más entre sí, en lugar de acercarse.
- Excluir a los revisores veteranos. La experiencia no protege a nadie contra los errores; la formación de actualización mejoró la fiabilidad incluso entre los evaluadores más experimentados.
- Reescribiré la rúbrica y lo dejaré ahí. Una rúbrica más clara por sí sola no garantiza la coherencia, ya que la experiencia del evaluador tiene más peso que el formato de la rúbrica a la hora de obtener puntuaciones fiables.
El primer error es el más... contraintuitivo. Una conversación que hace que todos los presentes se sientan en sintonía puede, de forma discreta, lograr que en esa sala se alcance un consenso local que ningún otro panel comparte.
La estructura es lo que lo evita. La puntuación independiente antes del debate y un conjunto de puntos de referencia compartidos mantienen la conversación centrada en un estándar en lugar de la voz más fuerte.
La exención para veteranos resulta tentadora por una sencilla razón. Los tiradores experimentados tienen confianza en sí mismos, y esa confianza se traduce en precisión, incluso cuando ambas cosas se han ido distanciando sin que nadie se diera cuenta.
El rediseño de la rúbrica tiene el mismo atractivo. Es siente Me gusta el progreso porque genera un resultado tangible, mientras que el trabajo más arduo de lograr que las personas se pongan de acuerdo queda en segundo plano.
Ninguno de estos errores es grave por sí solo. Se convierten en un gasto cuando un equipo da por sentado que la calibración es hecho y deja de comprobarlo.
Aprovechar la inercia entre ciclos
La calibración no es algo que se haga una sola vez, y el mantenimiento habitual es más sencillo de lo que parece.
La interpretación de los revisores va variando a medida que pasan los ciclos, se incorporan nuevas personas y se va desvaneciendo el recuerdo de la última sesión. Hay dos cifras clave que conviene vigilar:
- Una diferencia media de 10 puntos entre los evaluadores indica que es necesario actualizar la rúbrica.
- Una fiabilidad inferior al 75 % de coincidencia tras cuatro sesiones significa que los puntos de referencia necesitan un reescribir, sin más debate.
Organizar reuniones de seguimiento mensuales y llevar un registro conjunto de decisiones en el que se consigne por qué las ideas dudosas obtuvieron la puntuación que obtuvieron. De ese modo, el razonamiento se mantiene y no se vuelve a debatir.
Un jugador cuya puntuación se sitúe por encima o por debajo de la media del grupo aporta un dato útil. Ese patrón muestra exactamente dónde debería comenzar la próxima conversación sobre la calibración.
Incorporación de nuevos revisores
La incorporación de un nuevo evaluador a un panel calibrado no requiere reiniciar la sesión por completo. El panel ya cumple con el estándar; lo que hay que hacer es poner al día a una persona.
Empieza por evaluarlos comparándolos con tu conjunto de referencia ya puntuado. Esto imita el proceso formal de cualificación de los evaluadores, ya que exige alcanzar una tasa de coincidencia mínima en los ítems de referencia antes de proceder a la puntuación real.
Una implementación gradual evita que un nuevo revisor importe sus propios privado escala:
- Fíjate. Asiste a una sesión de calibración o de puntuación en directo —sin realizar la puntuación— para observar cómo razona el panel en voz alta.
- Puntuación conjunta. Evalúa las mismas ideas junto con un veterano, luego compara las puntuaciones y analiza cada diferencia.
- Anotar en solitario. Pasar a la puntuación independiente una vez que las diferencias en la puntuación conjunta se sitúen dentro del rango normal del panel.
Los estudios específicos sobre este escenario concreto son escasos.
La incorporación a un panel ya establecido y calibrado no se ha estudiado por sí misma. Lee esta secuencia como si fuera un sonido extrapolación basado en la práctica habitual en materia de cualificación, no en un hecho demostrado.
Establece un límite claro entre la corrección conjunta y el trabajo individual. Si la puntuación coincide con la de los evaluadores de referencia, o si la diferencia respecto a la del veterano es mínima, eso te indica que el revisor está listo.
Mantén el primer ciclo de trabajo individual bajo una ligera supervisión. Una rápida revisión aleatoria de las puntuaciones dudosas permite detectar a tiempo cualquier desviación antes de que se convierta en un hábito.
El papel de la IA
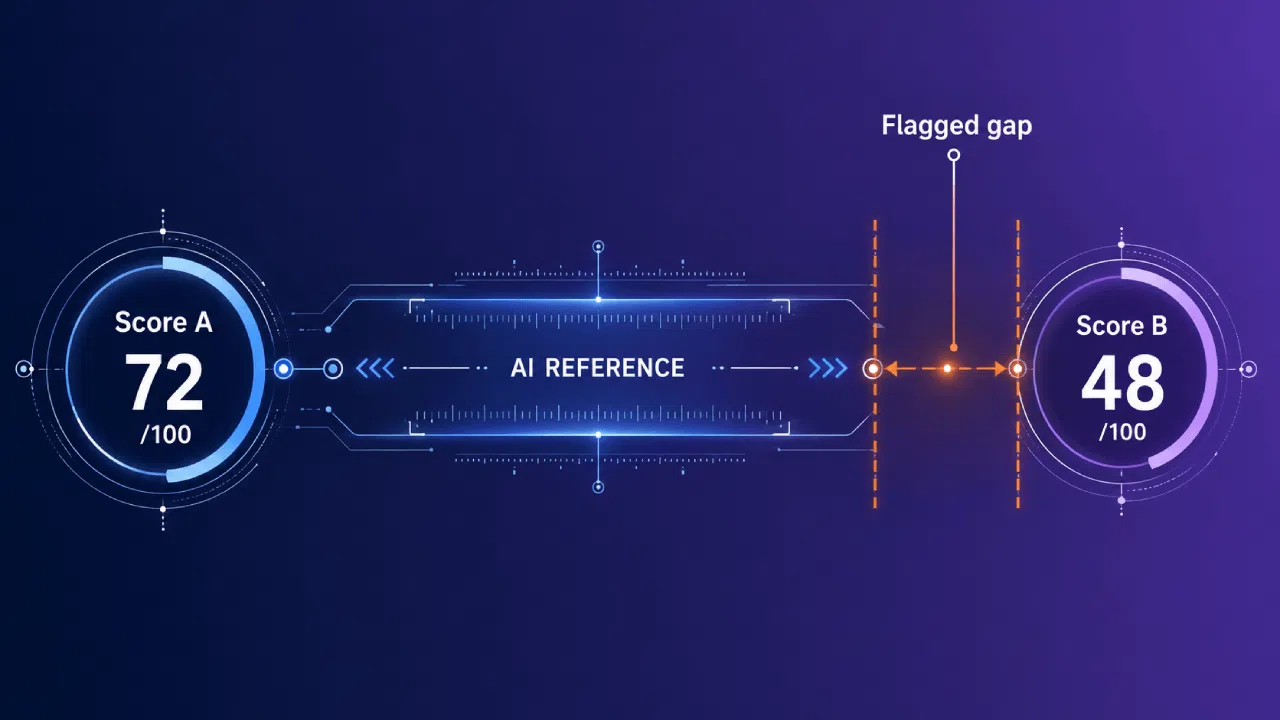
La IA funciona mejor aquí como un andamio que respalda la decisión del comité de revisión.
Hace visible el estándar implícito, pone de manifiesto los puntos en los que ambas puntuaciones divergen y ofrece al jurado un punto de referencia coherente con respecto al cual pronunciarse.
Las pruebas apuntan a que colaboración en ninguno de los dos extremos.
A estudio revisado por expertos Se constató que la corrección colaborativa entre personas y IA reducía la desviación respecto a los criterios de referencia de los expertos en mayor medida que cualquiera de los dos enfoques por separado.
Aquí es donde entra en juego el apoyo de la puntuación estructurada basada en IA:
- Criterios coherentes
- Escalas configurables
- Avisos automáticos de incoherencias
Esto permite a los revisores centrar su valoración en lo que realmente importa.
El resultado es cuantificable: menos puntuaciones controvertidas, un consenso más rápido y decisiones que el jurado puede defender con pruebas en lugar de instinto.
La calibración es el sistema que sustenta la tarjeta de puntuación
La eficacia de un cuadro de mando depende del grado de consenso que haya sobre su interpretación detrás de ello. Las cifras mira objetivo, pero tienen el significado que les han atribuido los críticos.
La calibración convierte ese entendimiento común en algo duradero:
- Un vocabulario común que explique qué significa realmente cada nivel de puntuación
- Una estructura de la sesión que evita que las primeras opiniones marquen el rumbo de la reunión
- Una forma de detectar la deriva antes de que, sin que nos demos cuenta, vuelva a definir lo que significa “bueno”
- Una vía más rápida para incorporar a nuevos revisores sin renunciar a los estándares
Los equipos que invierten en ello toman decisiones que espera un momento. Revisan menos, defienden sus puntuaciones con pruebas y generan en los revisores la confianza que aporta una estructura bien definida.
Tómatelo como un que se puede entrenar Disciplina. Una sola sesión no basta para que un equipo se compenetre de forma duradera, pero el trabajo se va acumulando a lo largo de los ciclos.
Empieza por los ejemplos clave. Son la medida más eficaz que puedes tomar este trimestre, y todo lo demás se basa en ellos.
Descargue nuestro ebook sobre evaluación de ideas y gobernanza, o reservar una demostración para ver cómo Accept Mission gestiona el enrutamiento automatizado, los flujos de trabajo de escalado y los registros de auditoría.




 English
 Dutch
 Portuguese
 Spanish
 French
 German
 Arabic